전체
국산 AI 서버 매니코어소프트 dg5W, MLPerf GPU 4장급 처리량 1위
엔비디아, 구글, 마이크로소프트 애저, AMD, 인텔, 델, HPE, 시스코 등 글로벌 기업이 참가하는 국제 AI 성능평가 ‘MLPerf Inference v6.1’에 국산 AI 서버가 이름을 올렸다.


 AI 서버의 핵심 부품인 GPU는 열이 많이 나 냉각이 성능을 좌우한다. 국내 기업이 이 GPU를 직접 액체로 식히는 방식으로 국제 공인 성능평가를 통과해 해외 서버와 같은 기준에서 성능을 검증받았다. PCIe 카드형 GPU를 직접액체냉각한 서버가 MLPerf Inference에 등재된 것은 글로벌 제조사를 포함해 이번이 처음이며, 국산 서버의 액체냉각 등재로도 첫 사례다. 실서비스 조건(Server) 처리량은 같은 평가에 제출된 가속기 4장 시스템 6종 가운데 1위로, 동일 GPU를 탑재한 글로벌 제조사 서버를 웃돌았다. 본 평가는 과학기술정보통신부, 정보통신산업진흥원(NIPA)이 지원하는 ‘친환경·고효율 AI 데이터센터 테스트베드 조성 및 실증 지원’ 사업의 일환으로 한국정보통신기술협회(TTA)와 공동 수행했다.
이 서버는 매니코어소프트가 자체 설계한 직접액체냉각 AI 서버 ‘DeepGadget dg5W’다. 매니코어소프트는 dg5W의 결과가 MLCommons의 검증을 거쳐 공식 결과로 공개됐다고 23일 밝혔다.
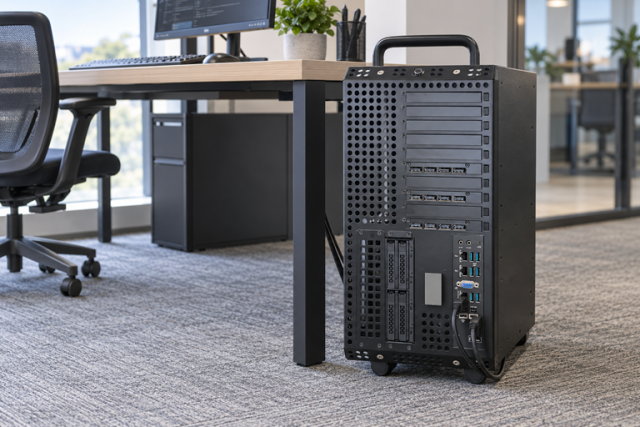
이번 평가의 시험과 성능 최적화, 국제 심사 대응은 국가 공인 시험인증기관인 TTA가 맡았다. dg5W는 워크스테이션 형태로 일반적인 사무실과 연구실에서 별도의 서버실 구축 없이 사용에 용이하다.
MLPerf는 125개 이상의 기업·대학·연구기관이 참여하는 AI 엔지니어링 컨소시엄 MLCommons가 주관한다. 참가 기관은 모두 동일한 AI 모델과 정확도 기준으로 성능을 측정하고, 결과는 참가 기관 간 상호 검증을 거쳐 공개된다. 이번 v6.1에는 역대 최다인 30개 기관이 참가했다.
생성형 AI가 답변을 만들 때 처리하는 텍스트의 최소 단위를 ‘토큰’이라고 한다. dg5W는 메타의 언어모델 Llama 3.1 8B 평가에서 1초에 약 2만4500개의 토큰을 처리했다. 요청이 연속으로 들어오는 실서비스 조건(Server)에서는 응답 지연시간 기준을 충족하면서 시스코 서버를 웃돌았다. 실제 서비스 조건에서도 서버가 낼 수 있는 최대 성능의 99.99%를 그대로 발휘했다. 같은 GPU를 쓴 다른 서버 3종은 97.2~98.3%였다. 국내 자체 기술로 설계한 고성능 AI 서버가 글로벌 제조사의 서버와 같은 모델, 같은 기준으로 평가받아 실서비스 조건의 두 지표에서 가장 높은 수치를 공식 결과로 남긴 것이다.
◇ 국산 AI 서버가 MLPerf에 남긴 기록
* MLCommons가 공개한 결과와 각 제출 기관의 시스템 명세를 기준으로 매니코어소프트가 집계
두 가지 조건에서 측정… 실서비스 조건에서도 처리량 유지
국산 AI 서버가 MLPerf Inference에 등재된 것은 2023년 9월 v3.1 라운드 이후 두 번째다.
dg5W가 등재된 부문은 Closed Division·Datacenter·Available이다(결과 ID 6.1-0102). Closed Division은 시스템 간 결과를 직접 비교할 수 있도록 평가 조건을 통일한 부문이고, Available은 현재 구매할 수 있는 상용 제품만 제출하는 분류다.
평가는 두 가지 조건에서 진행됐다. Offline은 지연시간 제한 없이 시스템의 최대 처리량을 측정한다. Server는 이용자 요청이 연속으로 유입되는 환경을 구성하고, 전체 요청의 99%가 첫 응답까지 걸리는 시간(TTFT) 2초 이내, 토큰 1개당 생성 시간(TPOT) 100ms 이내를 충족해야 유효한 결과로 인정한다.
dg5W의 Offline 처리량은 초당 2만4511.8토큰이다. Server 조건의 99% 기준 지연시간은 TTFT 약 1.51초, TPOT 약 85ms였으며, 초당 약 190건의 요청을 처리했다. 이 속도를 하루 동안 유지한다고 단순 환산하면 약 1640만 건의 요청, 약 21억 개의 토큰을 서버 1대가 처리하는 규모다.
같은 GPU, 같은 조건… 실서비스에서도 처리량 손실 없어
이번 라운드에서 Llama 3.1 8B 평가에 NVIDIA RTX PRO 6000 Blackwell Server Edition GPU로 결과를 제출한 시스템은 4종이다. HPE와 시스코가 3종을 제출했고, 국산 서버는 dg5W가 유일하다.
GPU 4장을 탑재한 시스코 서버와 비교하면 dg5W는 Server 조건에서 0.05% 높고, Offline 조건에서 1.61% 낮다. GPU 1장당 Server 처리량은 dg5W 6128토큰, 시스코 4장 서버 6125토큰이며 4종 전체는 6125~6190토큰 범위다. 처리량은 GPU와 소프트웨어가 결정하므로 동일한 GPU를 쓴 서버끼리는 수치가 비슷하게 나온다. 차이는 실서비스 조건에서 그 성능을 얼마나 유지하느냐에서 났다.
효율 지표: 지연시간 기준을 적용해도 처리량 99.99% 유지
Server 조건은 응답 지연시간 기준을 지켜야 하므로 기준이 없는 Offline 조건보다 처리량이 낮게 나오는 것이 일반적이다. Offline 처리량 대비 Server 처리량의 비율은 시스템이 가진 최대 성능을 실서비스 조건에서 얼마나 그대로 쓸 수 있는지를 나타낸다.
dg5W의 이 비율은 99.99%(2만4510.5÷2만4511.8)로 4종 가운데 가장 높다. 시스코 4장 서버는 98.33%, 시스코 8장 서버는 97.47%, HPE 서버는 97.17%다. 모두 공개된 두 수치를 그대로 나눈 값이다.
GPU 메모리 속도를 기준으로 비교한 처리량에서도 dg5W가 높게 나타났다. AI 서버의 처리량은 GPU가 메모리에서 데이터를 얼마나 빨리 읽어 오는지에 크게 좌우된다. dg5W에 탑재된 RTX PRO 6000 Blackwell은 초당 약 1.6TB를 읽는다. 초당 약 8TB를 읽는 B300·MI355X의 5분의 1 속도다.
각 GPU의 처리량을 이 속도로 나눠 같은 기준에서 비교하면 초당 1TB를 읽을 때 처리한 토큰 수는 dg5W가 약 3830개다. B300은 약 2450~2720개, MI355X는 약 2310~2360개, H200은 약 1540개다. 이 값은 매니코어소프트가 각 제조사의 공개 사양으로 환산한 분석값이며, MLCommons의 공식 지표는 아니다. 메모리 속도는 B300의 5분의 1이지만 GPU 1장당 처리량은 B300의 약 28%가 나온 것이다. Llama 3.1 8B와 같은 중소형 언어모델을 서비스할 때는 최상위 GPU가 아니어도 GPU 자원 대비 높은 처리량을 얻을 수 있다는 뜻이다.
성능을 뒷받침한 설계: PCIe GPU 직접액체냉각
dg5W는 GPU 4장을 직접액체냉각 방식으로 식힌다. 비교 대상인 HPE·시스코 서버 3종은 모두 공랭식이다. 공랭식 서버와 같은 수준의 처리량을 낸 것은 냉각 방식을 바꾸고도 GPU 성능을 손실 없이 끌어냈다는 의미다. 일반 서버의 확장 슬롯(PCIe)에 꽂는 카드형 GPU를 직접액체냉각한 서버가 MLPerf Inference 공식 결과를 받은 것은 글로벌 제조사를 포함해 dg5W가 처음이며, 국산 서버의 액체냉각 등재도 처음이다(공개 결과 기준 자체 분석).
엔비디아와 버티브의 공동 분석에 따르면 공랭식 데이터센터에 액체냉각을 약 75% 도입할 경우 서버 팬 전력은 최대 80%, 데이터센터 총 전력은 10.2% 줄어든다. 다만 dg5W의 전력 수치는 이번 공식 결과에 포함되지 않았다.
하드웨어 구성: NVIDIA RTX PRO 6000 GPU 4장 + 직접액체냉각
dg5W는 NVIDIA RTX PRO 6000 Blackwell Server Edition 96GB GPU 4장, AMD EPYC 9124 프로세서, 512GB DDR5 메모리로 구성됐다. 소프트웨어는 TensorRT 10.14.1.48, CUDA 13.1 기반이며 FP4 정밀도를 적용했다.
MLPerf는 시스템을 갖춘다고 결과가 나오는 평가가 아니다. 정확도 기준을 지키면서 지연시간 조건까지 맞추려면 시험 환경과 추론 엔진 설정을 반복해 조정해야 한다. TTA는 dg5W의 AI 시스템 환경을 구축해 성능을 측정하고, 데이터 병렬화 구성과 추론 백엔드 엔진을 조정해 지연시간 기준 안에서 처리량을 끌어올렸다. 실서비스 조건에서 최대 성능의 99.99%를 유지한 수치는 이 과정을 거쳐 나왔다. 결과는 9월 16일(현지시간) 공개됐다.
한주연 TTA AI인프라검증 팀장은 “이번 결과는 국내 제조사의 하드웨어 기술과 국내 시험기관의 검증 역량이 맞물려 나온 성과”라며 “NIPA 실증 지원 사업을 통해 국산 AI 인프라가 국제 무대에서 객관적으로 평가받을 수 있는 기반을 넓혀가겠다”고 말했다.
박정호 매니코어소프트 대표는 “고성능 GPU는 해외에서 들여오더라도 그 성능을 온전히 끌어내는 AI 서버는 국내 기술로 설계할 수 있다는 것을 공개 검증 절차로 확인받았다”며 “국내에서 설계한 서버가 글로벌 제조사의 서버와 같은 모델, 같은 기준으로 평가받아 실서비스 조건에서는 같은 GPU 4장을 쓴 글로벌 제조사 서버보다 높은 수치를 기록했다”고 말했다.
이어 “지연시간 기준을 지키면서도 최대 성능의 99.99%를 유지한 것은 GPU 성능을 실제 서비스에서 그대로 쓸 수 있다는 의미”라며 “앞으로도 공개 벤치마크를 통해 국산 AI 인프라의 성능을 검증받겠다”고 덧붙였다.
매니코어소프트 소개
매니코어소프트는 AI·고성능 컴퓨팅(HPC)용 GPU 서버를 국내에서 설계해 온 기업이다. 출발점은 서울대학교 슈퍼컴퓨터 ‘천둥’의 연구 성과다. 2012년 선보인 ‘천둥’은 세계 슈퍼컴퓨터 순위 Top 500에서 277위, 에너지 효율 순위 Green500에서 32위에 올랐다. 이후 워크스테이션 스케일의 섀시에 냉각 구조를 일체화한 GPU 서버 ‘딥가젯(deep gadget)’ 시리즈를 대학·연구소·기업 등 180곳 이상의 고객사에 공급해 왔으며, 2020년에는 액체냉각 시스템 특허를 등록했다. 이번에 MLPerf Inference v6.1에 등재된 DeepGadget dg5W는 2025년 출시한 dg5 시리즈의 서버로, 매니코어소프트가 자체 개발한 고성능 AI 서버다.
매니코어소프트의 직접액체냉각 AI 서버 ‘DeepGadget dg5W’(사진=매니코어소프트)
국산 AI 서버 ‘DeepGadget dg5W’의 MLPerf Inference 등재 기록
동일 GPU 탑재 시스템의 Llama 3.1 8B 결과
동일 GPU 탑재 4종의 GPU당 처리량과 처리량 유지율
PCIe 카드형 GPU 4장에 직접액체냉각을 적용한 dg5W 내부 구조
이 서버는 매니코어소프트가 자체 설계한 직접액체냉각 AI 서버 ‘DeepGadget dg5W’다. 매니코어소프트는 dg5W의 결과가 MLCommons의 검증을 거쳐 공식 결과로 공개됐다고 23일 밝혔다.
이번 평가의 시험과 성능 최적화, 국제 심사 대응은 국가 공인 시험인증기관인 TTA가 맡았다. dg5W는 워크스테이션 형태로 일반적인 사무실과 연구실에서 별도의 서버실 구축 없이 사용에 용이하다.
MLPerf는 125개 이상의 기업·대학·연구기관이 참여하는 AI 엔지니어링 컨소시엄 MLCommons가 주관한다. 참가 기관은 모두 동일한 AI 모델과 정확도 기준으로 성능을 측정하고, 결과는 참가 기관 간 상호 검증을 거쳐 공개된다. 이번 v6.1에는 역대 최다인 30개 기관이 참가했다.
생성형 AI가 답변을 만들 때 처리하는 텍스트의 최소 단위를 ‘토큰’이라고 한다. dg5W는 메타의 언어모델 Llama 3.1 8B 평가에서 1초에 약 2만4500개의 토큰을 처리했다. 요청이 연속으로 들어오는 실서비스 조건(Server)에서는 응답 지연시간 기준을 충족하면서 시스코 서버를 웃돌았다. 실제 서비스 조건에서도 서버가 낼 수 있는 최대 성능의 99.99%를 그대로 발휘했다. 같은 GPU를 쓴 다른 서버 3종은 97.2~98.3%였다. 국내 자체 기술로 설계한 고성능 AI 서버가 글로벌 제조사의 서버와 같은 모델, 같은 기준으로 평가받아 실서비스 조건의 두 지표에서 가장 높은 수치를 공식 결과로 남긴 것이다.
◇ 국산 AI 서버가 MLPerf에 남긴 기록
* MLCommons가 공개한 결과와 각 제출 기관의 시스템 명세를 기준으로 매니코어소프트가 집계
두 가지 조건에서 측정… 실서비스 조건에서도 처리량 유지
국산 AI 서버가 MLPerf Inference에 등재된 것은 2023년 9월 v3.1 라운드 이후 두 번째다.
dg5W가 등재된 부문은 Closed Division·Datacenter·Available이다(결과 ID 6.1-0102). Closed Division은 시스템 간 결과를 직접 비교할 수 있도록 평가 조건을 통일한 부문이고, Available은 현재 구매할 수 있는 상용 제품만 제출하는 분류다.
평가는 두 가지 조건에서 진행됐다. Offline은 지연시간 제한 없이 시스템의 최대 처리량을 측정한다. Server는 이용자 요청이 연속으로 유입되는 환경을 구성하고, 전체 요청의 99%가 첫 응답까지 걸리는 시간(TTFT) 2초 이내, 토큰 1개당 생성 시간(TPOT) 100ms 이내를 충족해야 유효한 결과로 인정한다.
dg5W의 Offline 처리량은 초당 2만4511.8토큰이다. Server 조건의 99% 기준 지연시간은 TTFT 약 1.51초, TPOT 약 85ms였으며, 초당 약 190건의 요청을 처리했다. 이 속도를 하루 동안 유지한다고 단순 환산하면 약 1640만 건의 요청, 약 21억 개의 토큰을 서버 1대가 처리하는 규모다.
같은 GPU, 같은 조건… 실서비스에서도 처리량 손실 없어
이번 라운드에서 Llama 3.1 8B 평가에 NVIDIA RTX PRO 6000 Blackwell Server Edition GPU로 결과를 제출한 시스템은 4종이다. HPE와 시스코가 3종을 제출했고, 국산 서버는 dg5W가 유일하다.
GPU 4장을 탑재한 시스코 서버와 비교하면 dg5W는 Server 조건에서 0.05% 높고, Offline 조건에서 1.61% 낮다. GPU 1장당 Server 처리량은 dg5W 6128토큰, 시스코 4장 서버 6125토큰이며 4종 전체는 6125~6190토큰 범위다. 처리량은 GPU와 소프트웨어가 결정하므로 동일한 GPU를 쓴 서버끼리는 수치가 비슷하게 나온다. 차이는 실서비스 조건에서 그 성능을 얼마나 유지하느냐에서 났다.
효율 지표: 지연시간 기준을 적용해도 처리량 99.99% 유지
Server 조건은 응답 지연시간 기준을 지켜야 하므로 기준이 없는 Offline 조건보다 처리량이 낮게 나오는 것이 일반적이다. Offline 처리량 대비 Server 처리량의 비율은 시스템이 가진 최대 성능을 실서비스 조건에서 얼마나 그대로 쓸 수 있는지를 나타낸다.
dg5W의 이 비율은 99.99%(2만4510.5÷2만4511.8)로 4종 가운데 가장 높다. 시스코 4장 서버는 98.33%, 시스코 8장 서버는 97.47%, HPE 서버는 97.17%다. 모두 공개된 두 수치를 그대로 나눈 값이다.
GPU 메모리 속도를 기준으로 비교한 처리량에서도 dg5W가 높게 나타났다. AI 서버의 처리량은 GPU가 메모리에서 데이터를 얼마나 빨리 읽어 오는지에 크게 좌우된다. dg5W에 탑재된 RTX PRO 6000 Blackwell은 초당 약 1.6TB를 읽는다. 초당 약 8TB를 읽는 B300·MI355X의 5분의 1 속도다.
각 GPU의 처리량을 이 속도로 나눠 같은 기준에서 비교하면 초당 1TB를 읽을 때 처리한 토큰 수는 dg5W가 약 3830개다. B300은 약 2450~2720개, MI355X는 약 2310~2360개, H200은 약 1540개다. 이 값은 매니코어소프트가 각 제조사의 공개 사양으로 환산한 분석값이며, MLCommons의 공식 지표는 아니다. 메모리 속도는 B300의 5분의 1이지만 GPU 1장당 처리량은 B300의 약 28%가 나온 것이다. Llama 3.1 8B와 같은 중소형 언어모델을 서비스할 때는 최상위 GPU가 아니어도 GPU 자원 대비 높은 처리량을 얻을 수 있다는 뜻이다.
성능을 뒷받침한 설계: PCIe GPU 직접액체냉각
dg5W는 GPU 4장을 직접액체냉각 방식으로 식힌다. 비교 대상인 HPE·시스코 서버 3종은 모두 공랭식이다. 공랭식 서버와 같은 수준의 처리량을 낸 것은 냉각 방식을 바꾸고도 GPU 성능을 손실 없이 끌어냈다는 의미다. 일반 서버의 확장 슬롯(PCIe)에 꽂는 카드형 GPU를 직접액체냉각한 서버가 MLPerf Inference 공식 결과를 받은 것은 글로벌 제조사를 포함해 dg5W가 처음이며, 국산 서버의 액체냉각 등재도 처음이다(공개 결과 기준 자체 분석).
엔비디아와 버티브의 공동 분석에 따르면 공랭식 데이터센터에 액체냉각을 약 75% 도입할 경우 서버 팬 전력은 최대 80%, 데이터센터 총 전력은 10.2% 줄어든다. 다만 dg5W의 전력 수치는 이번 공식 결과에 포함되지 않았다.
하드웨어 구성: NVIDIA RTX PRO 6000 GPU 4장 + 직접액체냉각
dg5W는 NVIDIA RTX PRO 6000 Blackwell Server Edition 96GB GPU 4장, AMD EPYC 9124 프로세서, 512GB DDR5 메모리로 구성됐다. 소프트웨어는 TensorRT 10.14.1.48, CUDA 13.1 기반이며 FP4 정밀도를 적용했다.
MLPerf는 시스템을 갖춘다고 결과가 나오는 평가가 아니다. 정확도 기준을 지키면서 지연시간 조건까지 맞추려면 시험 환경과 추론 엔진 설정을 반복해 조정해야 한다. TTA는 dg5W의 AI 시스템 환경을 구축해 성능을 측정하고, 데이터 병렬화 구성과 추론 백엔드 엔진을 조정해 지연시간 기준 안에서 처리량을 끌어올렸다. 실서비스 조건에서 최대 성능의 99.99%를 유지한 수치는 이 과정을 거쳐 나왔다. 결과는 9월 16일(현지시간) 공개됐다.
한주연 TTA AI인프라검증 팀장은 “이번 결과는 국내 제조사의 하드웨어 기술과 국내 시험기관의 검증 역량이 맞물려 나온 성과”라며 “NIPA 실증 지원 사업을 통해 국산 AI 인프라가 국제 무대에서 객관적으로 평가받을 수 있는 기반을 넓혀가겠다”고 말했다.
박정호 매니코어소프트 대표는 “고성능 GPU는 해외에서 들여오더라도 그 성능을 온전히 끌어내는 AI 서버는 국내 기술로 설계할 수 있다는 것을 공개 검증 절차로 확인받았다”며 “국내에서 설계한 서버가 글로벌 제조사의 서버와 같은 모델, 같은 기준으로 평가받아 실서비스 조건에서는 같은 GPU 4장을 쓴 글로벌 제조사 서버보다 높은 수치를 기록했다”고 말했다.
이어 “지연시간 기준을 지키면서도 최대 성능의 99.99%를 유지한 것은 GPU 성능을 실제 서비스에서 그대로 쓸 수 있다는 의미”라며 “앞으로도 공개 벤치마크를 통해 국산 AI 인프라의 성능을 검증받겠다”고 덧붙였다.
매니코어소프트 소개
매니코어소프트는 AI·고성능 컴퓨팅(HPC)용 GPU 서버를 국내에서 설계해 온 기업이다. 출발점은 서울대학교 슈퍼컴퓨터 ‘천둥’의 연구 성과다. 2012년 선보인 ‘천둥’은 세계 슈퍼컴퓨터 순위 Top 500에서 277위, 에너지 효율 순위 Green500에서 32위에 올랐다. 이후 워크스테이션 스케일의 섀시에 냉각 구조를 일체화한 GPU 서버 ‘딥가젯(deep gadget)’ 시리즈를 대학·연구소·기업 등 180곳 이상의 고객사에 공급해 왔으며, 2020년에는 액체냉각 시스템 특허를 등록했다. 이번에 MLPerf Inference v6.1에 등재된 DeepGadget dg5W는 2025년 출시한 dg5 시리즈의 서버로, 매니코어소프트가 자체 개발한 고성능 AI 서버다.
공유하기
← 블로그 목록으로